第三章:使用 SQLite 开发 Health Tracker 饮食记录工具
上一章,我们使用 Python 和 MCP SDK 2.x 创建了第一个 MCP Server,并且通过 MCP Inspector 成功调用了 hello 和 add 两个工具。
但它们有一个共同的问题:只能返回结果,不能保存数据。
例如,我们调用 add(10, 20),得到了 30。可是程序结束后,这次计算并没有留下任何记录。
现在,我希望实现一个真正有用的功能:
今天早餐吃了一根香蕉,热量大约是 105 千卡,帮我记录一下。
不仅要保存这条饮食记录,还要保证关闭程序、重新启动之后,数据仍然存在。
这就需要引入数据库。
本章我们先不连接 ChatGPT,而是使用 MCP Inspector 完成整个数据保存和查询流程。
本章目标:
- 使用 SQLite 创建健康记录数据库。
- 设计饮食记录表。
- 开发
record_food工具,保存饮食数据。 - 开发
get_food_records工具,查询历史记录。 - 通过 MCP Inspector 验证数据持久化。
3.1 为什么需要数据库?
我们先从一个最简单的 Python 例子开始。
假设使用列表保存饮食记录:
foods = []

foods.append({
    "name": "香蕉",
    "calories": 105
})

print(foods)
运行结果:
[{'name': '香蕉', 'calories': 105}]
看起来没有什么问题。
但是,当我们关闭 Python 程序后,列表中的数据也就消失了。
下一次重新启动程序,foods 又变成一个空列表。
当然,我们可以将数据写入 JSON 文件。
但是,随着功能越来越多,我们还需要按日期查询、统计热量、修改记录、删除记录。
这时,数据库就更加合适了。
为什么选择 SQLite?
Python 开发中常见的数据库包括 SQLite、MySQL 和 PostgreSQL。
它们都可以保存饮食记录。
但对于目前的 Health Tracker,我选择 SQLite。
原因很简单:我们的项目目前只是一个个人健康记录系统,不需要一开始就引入复杂的数据库服务。
SQLite 有几个非常适合这个项目的特点:
- 不需要单独安装和启动数据库服务器。
- Python 标准库已经提供了
sqlite3模块。 - 数据保存在一个数据库文件中。
- 支持 SQL 查询、修改、删除和统计。
- 后续可以随 MCP Server 一起部署到云服务器。
例如,数据库文件可以叫作:
health.db
这个文件里面就可以保存我们所有的健康记录。
需要注意,SQLite 并不意味着只能用于测试。对于低并发、单机运行的个人应用,它完全可以作为正式数据库使用。
3.2 设计饮食记录表
在编写代码之前,我们先思考一个问题:
一条饮食记录应该保存哪些信息?
如果只保存食物名称和热量,显然不够。
比如:
2026 年 10 月 20 日,中午吃了一根鸡腿,估计 180 千卡。
至少需要知道日期、餐次、食物名称和热量。
而后面我们还希望统计蛋白质、碳水化合物和脂肪,所以最好一开始就预留这些字段。
饮食记录表结构
表名:food_records
| 字段 | 类型 | 作用 |
|---|---|---|
| id | INTEGER | 每条记录的唯一编号 |
| record_date | TEXT | 饮食日期 |
| meal_type | TEXT | 餐次 |
| food_name | TEXT | 食物名称 |
| calories | REAL | 热量,单位 kcal |
| weight_g | REAL | 可食部分重量,单位 g |
| protein_g | REAL | 蛋白质,单位 g |
| carbs_g | REAL | 碳水化合物,单位 g |
| fat_g | REAL | 脂肪,单位 g |
| notes | TEXT | 备注及估算依据 |
这里有两个设计细节。
第一,为什么日期使用 TEXT?
因为 SQLite 没有独立的 DATE 存储类型。
我们可以统一使用 YYYY-MM-DD 格式保存日期,例如:
2026-10-20
这种格式方便排序,也便于按日期查询。
第二,为什么营养字段允许为空?
因为现实中,我们不一定知道每种食物的准确营养成分。
例如,用户可能只知道自己吃了一个包子,但不知道它的重量。
对于未知数据,我们应该保存 NULL,而不是随便填一个 0。
NULL 表示未知;0 表示数值确实为零。
这两者在数据分析中有本质区别。
3.3 创建 SQLite 数据库
现在开始动手。
我们在项目根目录中新建一个文件:
db.py
项目结构变成:
health-tracker-agent/
├── .venv/
├── main.py
├── db.py
├── pyproject.toml
└── uv.lock
接下来编写数据库初始化代码。
第一步:连接 SQLite
打开 db.py:
import sqlite3
from pathlib import Path

DB_PATH = Path(__file__).resolve().parent / "health.db"


def get_connection():
    conn = sqlite3.connect(DB_PATH)
    conn.row_factory = sqlite3.Row
    return conn
这段代码包含三个知识点。
首先:
sqlite3.connect(DB_PATH)
负责连接数据库。
如果数据库文件不存在,SQLite 会自动创建它。
其次:
Path(__file__).resolve().parent
获取 db.py 所在目录。
这样,不管我们从哪个工作目录启动 Python,数据库都可以使用固定的文件路径。
最后:
conn.row_factory = sqlite3.Row
让查询结果能够通过字段名称读取。
例如:
row["food_name"]
而不必记住每个字段在查询结果中的位置。
第二步:创建数据表
继续在 db.py 中添加:
def init_db():
    with get_connection() as conn:
        conn.execute("""
            CREATE TABLE IF NOT EXISTS food_records (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                record_date TEXT NOT NULL,
                meal_type TEXT NOT NULL,
                food_name TEXT NOT NULL,
                calories REAL,
                weight_g REAL,
                protein_g REAL,
                carbs_g REAL,
                fat_g REAL,
                notes TEXT
            )
        """)
这里最关键的是:
CREATE TABLE IF NOT EXISTS food_records
意思是:
如果 food_records 表不存在,就创建它;如果已经存在,就不再重复创建。
这样,每次启动 MCP Server 时,我们都可以安全地调用 init_db()。
另外:
id INTEGER PRIMARY KEY AUTOINCREMENT
表示每条记录都有一个自动生成的唯一编号。
例如:
| id | food_name | calories |
|---|---|---|
| 1 | 香蕉 | 105 |
| 2 | 鸡腿 | 180 |
| 3 | 米饭 | 232 |
为什么需要 ID?
因为以后修改或删除记录时,我们必须能够准确定位到某一条数据。
如果只根据食物名称删除,就可能误删其他日期的同名食物。
第三步:测试数据库创建
在 db.py 最后添加:
if __name__ == "__main__":
    init_db()
    print(f"数据库初始化完成:{DB_PATH}")
运行:
uv run python db.py
正常情况下,会输出数据库文件的位置。
此时项目中应该出现:
health.db
这说明 SQLite 数据库已经创建成功。
不过,数据库目前还是空的。
下一步,我们要编写真正保存数据的功能。
3.4 编写保存饮食记录的 Python 函数
先不要急着注册 MCP 工具。
我们先把数据库操作封装成一个普通 Python 函数。
这样做有一个好处:
数据库逻辑与 MCP 工具接口可以分开。
将来即使不使用 MCP,我们也可以在其他 Python 程序中复用这些数据库操作。
在 db.py 中添加:
def insert_food(
    record_date: str,
    meal_type: str,
    food_name: str,
    calories: float | None = None,
    weight_g: float | None = None,
    protein_g: float | None = None,
    carbs_g: float | None = None,
    fat_g: float | None = None,
    notes: str | None = None,
) -> int:
    with get_connection() as conn:
        cursor = conn.execute(
            """
            INSERT INTO food_records (
                record_date,
                meal_type,
                food_name,
                calories,
                weight_g,
                protein_g,
                carbs_g,
                fat_g,
                notes
            )
            VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                record_date,
                meal_type,
                food_name,
                calories,
                weight_g,
                protein_g,
                carbs_g,
                fat_g,
                notes,
            ),
        )

        return cursor.lastrowid
这里使用了 SQL 的 INSERT INTO 语句。
它负责向 food_records 表中插入一条记录。
注意 SQL 中的问号:
VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)
这些问号是参数占位符。
实际数据通过后面的元组传入,而不是直接拼接到 SQL 字符串中。
这是非常重要的习惯,可以避免因字符串拼接而产生 SQL 注入问题。
为什么要返回 lastrowid?
注意最后一行:
return cursor.lastrowid
它返回刚刚插入记录的 ID。
例如,我们新增一条香蕉记录,数据库生成 ID 为 1。
之后如果想修改或删除这条记录,就可以使用这个 ID。
所以,保存成功之后返回记录 ID,是一个很实用的接口设计。
3.5 开发第一个真正的 MCP 工具:record_food
现在,我们已经有了数据库和插入函数。
接下来,把它们与 MCP Server 连接起来。
打开 main.py。
上一章的 hello 和 add 工具可以暂时删除,我们开始编写 Health Tracker 的正式功能。
from datetime import date

from mcp.server.mcpserver import MCPServer

from db import init_db, insert_food


mcp = MCPServer("Health Tracker")


@mcp.tool()
def record_food(
    record_date: str,
    meal_type: str,
    food_name: str,
    calories: float | None = None,
    weight_g: float | None = None,
    protein_g: float | None = None,
    carbs_g: float | None = None,
    fat_g: float | None = None,
    notes: str | None = None,
) -> dict:
    """
    保存一条饮食记录。

    参数:
    - record_date:饮食日期,格式 YYYY-MM-DD
    - meal_type:餐次,breakfast/lunch/dinner/snack
    - food_name:食物名称
    - calories:热量,单位 kcal
    - weight_g:可食部分重量,单位 g
    - protein_g:蛋白质,单位 g
    - carbs_g:碳水化合物,单位 g
    - fat_g:脂肪,单位 g
    - notes:备注或营养估算依据

    对于未知的营养数据,使用 None,不要用 0 代替。
    """

    try:
        parsed_date = date.fromisoformat(record_date)

        if parsed_date.isoformat() != record_date:
            raise ValueError("日期格式必须为 YYYY-MM-DD")

        allowed_meals = {
            "breakfast",
            "lunch",
            "dinner",
            "snack",
        }

        if meal_type not in allowed_meals:
            raise ValueError(
                "meal_type 必须是 breakfast、lunch、dinner 或 snack"
            )

        if not food_name.strip():
            raise ValueError("食物名称不能为空")

        nutrition = {
            "calories": calories,
            "weight_g": weight_g,
            "protein_g": protein_g,
            "carbs_g": carbs_g,
            "fat_g": fat_g,
        }

        for field, value in nutrition.items():
            if value is not None and not (0 <= value < float("inf")):
                raise ValueError(f"{field} 必须是有限的非负数")

        record_id = insert_food(
            record_date=record_date,
            meal_type=meal_type,
            food_name=food_name.strip(),
            calories=calories,
            weight_g=weight_g,
            protein_g=protein_g,
            carbs_g=carbs_g,
            fat_g=fat_g,
            notes=notes,
        )

        return {
            "success": True,
            "record_id": record_id,
            "message": "饮食记录保存成功",
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }


if __name__ == "__main__":
    init_db()

    mcp.run(
        transport="streamable-http",
        host="127.0.0.1",
        port=8000,
    )
这段代码看起来比较长,但实际上只做了三件事情:
- 接收 MCP 客户端传来的参数。
- 验证日期、餐次和营养数值。
- 调用
insert_food()将数据保存到 SQLite。
这里的参数校验非常重要。
因为将来 ChatGPT 生成的工具参数,也应该由 MCP Server 再次验证,而不能无条件信任。
为什么参数中使用 float | None?
例如:
protein_g: float | None = None
表示蛋白质既可以是一个浮点数,也可以是 None。
当我们知道蛋白质含量时,可以传入:
{
  "protein_g": 1.3
}
如果不知道,就可以不传这个参数。
这样数据库中会保存 NULL,而不是错误地保存为 0。
3.6 使用 MCP Inspector 保存第一条饮食记录
现在重新启动 MCP Server:
uv run python main.py
打开 MCP Inspector,使用 Streamable HTTP 连接:
http://127.0.0.1:8000/mcp
进入 Tools 页面。
现在应该能够看到:
record_food
选择这个工具。
测试一:记录一根香蕉
输入以下参数:
{
  "record_date": "2026-10-20",
  "meal_type": "breakfast",
  "food_name": "香蕉",
  "calories": 105,
  "weight_g": 118,
  "protein_g": 1.3,
  "carbs_g": 27,
  "fat_g": 0.4,
  "notes": "中等大小香蕉一根,营养数据为估算值"
}
点击执行。
如果保存成功,返回结果类似:
{
  "success": true,
  "record_id": 1,
  "message": "饮食记录保存成功"
}
其中 record_id 的实际数值取决于数据库中已有的记录。
这时,我们已经完成了一个非常关键的步骤:
通过 MCP 客户端调用 Python 工具,将真实数据保存到了 SQLite 数据库。
不过,现在还有一个问题。
我们怎么确认这条记录真的写进数据库了?
不能只看工具返回成功,还需要查询数据库。
3.7 开发查询饮食记录工具
我们先在 db.py 中增加一个查询函数。
def select_food_records(record_date: str) -> list[dict]:
    with get_connection() as conn:
        rows = conn.execute(
            """
            SELECT
                id,
                record_date,
                meal_type,
                food_name,
                calories,
                weight_g,
                protein_g,
                carbs_g,
                fat_g,
                notes
            FROM food_records
            WHERE record_date = ?
            ORDER BY id
            """,
            (record_date,),
        ).fetchall()

        return [dict(row) for row in rows]
这里使用了 SQL 的 SELECT 语句。
其中:
WHERE record_date = ?
表示只查询指定日期的饮食记录。
例如:
2026-10-20
就只返回这一天的数据。
注意:
return [dict(row) for row in rows]
它将 SQLite 查询结果转换成 Python 字典列表。
这样 MCP Server 就可以方便地返回结构化数据。
注册查询工具
接下来,修改 main.py 中的导入语句:
from db import init_db, insert_food, select_food_records
然后在 record_food 工具后面添加:
@mcp.tool()
def get_food_records(record_date: str) -> dict:
    """
    查询指定日期的所有饮食记录。

    参数:
    - record_date:查询日期,格式 YYYY-MM-DD
    """

    try:
        parsed_date = date.fromisoformat(record_date)

        if parsed_date.isoformat() != record_date:
            raise ValueError("日期格式必须为 YYYY-MM-DD")

        records = select_food_records(record_date)

        return {
            "success": True,
            "record_date": record_date,
            "count": len(records),
            "records": records,
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }
到这里,我们的 MCP Server 已经有两个正式工具:
| 工具 | 功能 |
|---|---|
record_food | 保存一条饮食记录 |
get_food_records | 查询指定日期的饮食记录 |
保存文件后,重新启动 MCP Server,并在 Inspector 中重新连接或刷新工具列表。
测试查询
调用:
get_food_records
输入:
{
  "record_date": "2026-10-20"
}
如果之前成功保存了一根香蕉,就会返回类似:
{
  "success": true,
  "record_date": "2026-10-20",
  "count": 1,
  "records": [
    {
      "id": 1,
      "record_date": "2026-10-20",
      "meal_type": "breakfast",
      "food_name": "香蕉",
      "calories": 105,
      "weight_g": 118,
      "protein_g": 1.3,
      "carbs_g": 27,
      "fat_g": 0.4,
      "notes": "中等大小香蕉一根,营养数据为估算值"
    }
  ]
}
这样就说明,我们不仅能保存数据,还能够将数据库中的真实记录查询出来。
3.8 计算当天摄入的总热量
既然已经能够查询饮食记录,我们还可以进一步增加一个统计功能。
例如:
2026 年 10 月 20 日,我一共摄入了多少热量?
对于这个问题,我们不需要让 Python 逐条读取后再手动累加。
SQLite 本身就支持聚合函数。
在 db.py 中添加:
def select_daily_calories(record_date: str) -> dict:
    with get_connection() as conn:
        row = conn.execute(
            """
            SELECT
                COUNT(*) AS record_count,
                COUNT(calories) AS known_calorie_count,
                SUM(calories) AS total_calories
            FROM food_records
            WHERE record_date = ?
            """,
            (record_date,),
        ).fetchone()

        return {
            "record_count": row["record_count"],
            "known_calorie_count": row["known_calorie_count"],
            "total_calories": row["total_calories"],
        }
这里使用了两个 SQL 聚合函数:
COUNT(*)
统计记录数量。
SUM(calories)
计算已知热量的总和。
需要注意,SUM 会忽略 NULL。
如果有三条饮食记录,其中一条没有热量数据,那么计算出来的结果只包含另外两条。
因此,我们额外返回 known_calorie_count,用来判断统计结果是否完整。
注册统计工具
在 main.py 中增加导入:
from db import (
    init_db,
    insert_food,
    select_food_records,
    select_daily_calories,
)
继续添加:
@mcp.tool()
def get_daily_calories(record_date: str) -> dict:
    """统计指定日期的热量摄入情况。"""

    try:
        parsed_date = date.fromisoformat(record_date)

        if parsed_date.isoformat() != record_date:
            raise ValueError("日期格式必须为 YYYY-MM-DD")

        summary = select_daily_calories(record_date)

        return {
            "success": True,
            "record_date": record_date,
            **summary,
            "is_complete": (
                summary["record_count"]
                == summary["known_calorie_count"]
            ),
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }
重新启动 MCP Server。
现在我们有三个工具:
record_food
get_food_records
get_daily_calories
假设当天记录了以下食物:
| 食物 | 热量 |
|---|---|
| 香蕉 | 105 kcal |
| 米饭 | 232 kcal |
| 鸡腿 | 180 kcal |
调用 get_daily_calories 后,应该得到:
{
  "success": true,
  "record_date": "2026-10-20",
  "record_count": 3,
  "known_calorie_count": 3,
  "total_calories": 517,
  "is_complete": true
}
如果存在未知热量的记录,is_complete 就会是 false。
这样可以避免把不完整的统计结果误认为全天实际摄入总量。
3.9 验证 SQLite 数据持久化
接下来,我们做一个非常重要的实验。
首先,使用 Inspector 新增几条饮食记录。
然后,在运行 MCP Server 的终端按下:
Ctrl + C
停止 Python 程序。
重新运行:
uv run python main.py
回到 Inspector,重新连接 MCP Server。
再次调用:
get_food_records
查询刚才的日期。
如果记录仍然存在,就说明数据并没有因为 Python 程序停止而丢失。
这是因为数据已经写入:
health.db
而不是保存在 Python 的内存变量中。
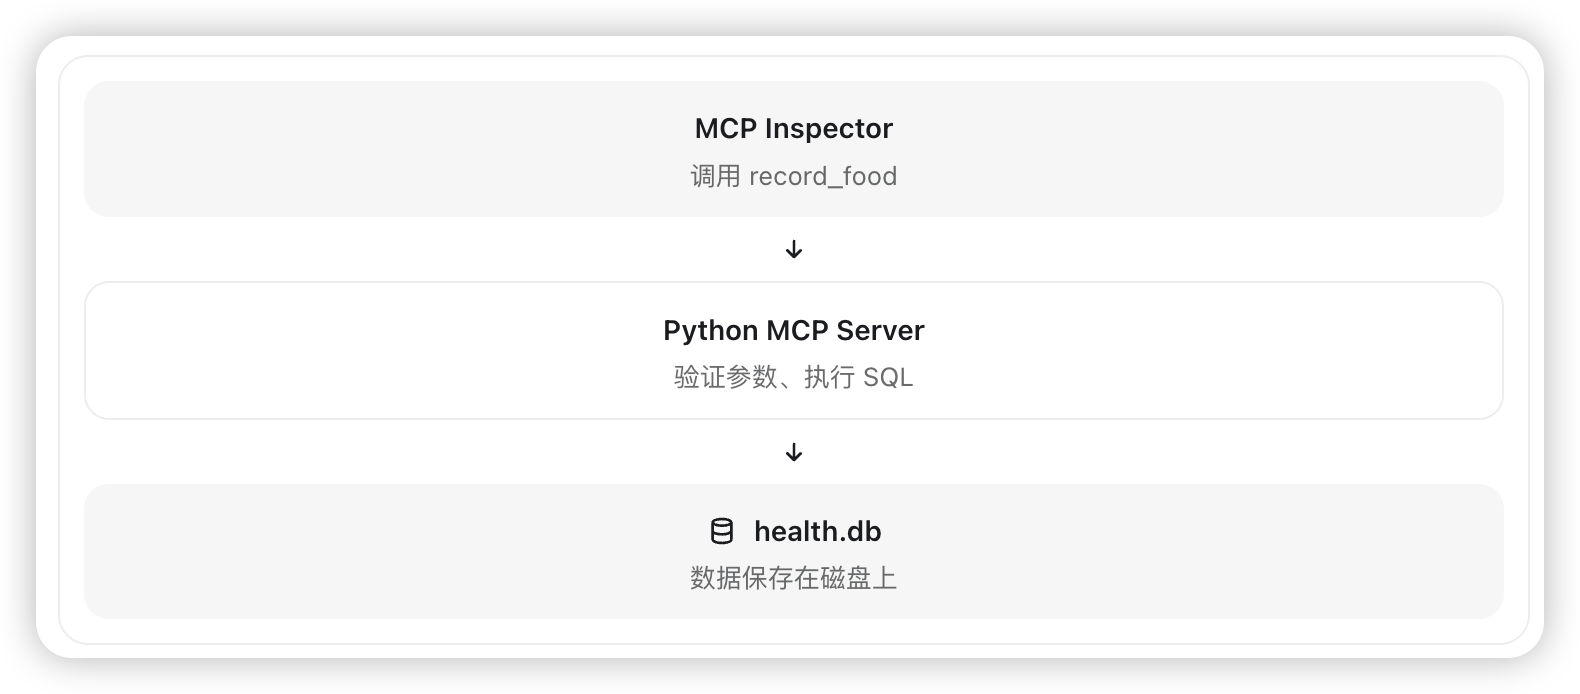
这意味着我们已经实现了 Health Tracker 最基础、也是最重要的能力:持久化保存健康数据。
当然,持久化不等于备份。如果数据库文件被误删或者磁盘损坏,数据仍然可能丢失。后面部署到阿里云时,我们会专门讲解数据库持久化和备份。
3.10 为什么不直接在 MCP 工具中写 SQL?
回顾本章代码,我们把程序拆成了两个文件:
health-tracker-agent/
├── main.py
├── db.py
├── health.db
├── pyproject.toml
└── uv.lock
其中:
main.py:负责 MCP 接口。
它接收客户端参数、验证输入、调用数据库函数,再返回结果。
db.py:负责数据库操作。
它负责连接 SQLite、创建表、插入记录、查询数据和统计热量。
这样拆分有两个好处。
首先,代码更容易维护。
如果以后想修改数据库表结构,我们主要修改 db.py,不需要把所有 SQL 混在 MCP 工具代码中。
其次,方便复用。
假设以后我们还想开发一个 SwiftUI 健康记录 App,也可以通过独立的后端接口复用相同的数据访问逻辑。
所以,即使是一个小项目,也值得从一开始就保持清晰的职责划分。
3.11 常见问题
问题一:为什么修改代码后,新工具没有出现?
因为 Python 服务通常不会自动重新加载工具定义。
修改 main.py 后,需要重新启动 MCP Server,并在 Inspector 中刷新工具列表或重新连接。
后面接入 ChatGPT 时,还会涉及插件工具定义的刷新问题。
问题二:为什么 SQLite 中出现了重复记录?
因为每次调用 record_food,都会执行一次 INSERT。
即使两次传入完全相同的食物名称、日期和热量,数据库也会创建两条独立记录。
对于饮食记录来说,这种行为并不一定是错误的。
例如,一天可能吃两次香蕉。
但如果是因为网络重试导致的重复写入,就需要进一步考虑幂等性设计。我们会在后续完善数据管理时讨论这个问题。
问题三:能不能直接打开 health.db 查看数据?
可以。
你可以使用 SQLite 数据库可视化工具,也可以通过 Python 或 SQLite 命令行查看。
例如,如果安装了 SQLite 命令行工具:
sqlite3 health.db
执行:
SELECT * FROM food_records;
就能查看保存的数据。
退出:
.quit
问题四:为什么热量使用 REAL 类型?
因为热量和营养成分不一定都是整数。
例如:
蛋白质:1.3 g
脂肪:0.4 g
使用 REAL 可以保存浮点数。
不过,浮点数不适合要求严格十进制精度的金融计算。对于本项目中的估算营养数据,使用 REAL 是合理的。
问题五:SQLite 可以保存多少条饮食记录?
对于个人饮食记录应用,SQLite 的容量通常不是瓶颈。
假设每天保存 10 条记录,一年大约是 3650 条,十年也只有约 36500 条。
这样的数据规模对 SQLite 来说非常小。
因此,我们没有必要一开始就引入 MySQL。
3.12 本章总结
这一章,我们正式开始开发 Health Tracker。
与上一章的 hello、add 不同,现在的 MCP 工具已经可以操作真实数据库。
我们完成了以下功能:
| 工具 | 功能 | 是否完成 |
|---|---|---|
record_food | 保存饮食记录 | |
get_food_records | 查询指定日期的记录 | |
get_daily_calories | 统计指定日期的热量 |
同时,我们还学习了 SQLite 的基本使用方法,包括创建数据库、设计表结构、执行 SQL 和读取查询结果。
最重要的是,我们已经验证:
即使关闭 MCP Server,再次启动后,之前保存的饮食记录仍然存在。
但是,现在的 Health Tracker 还有两个明显的不足。
第一,它只能记录饮食,不能记录运动、体重和断食。
第二,我们仍然需要通过 MCP Inspector 手动填写参数。
例如,记录香蕉时,需要自己输入:
{
  "food_name": "香蕉",
  "calories": 105,
  "protein_g": 1.3,
  "carbs_g": 27,
  "fat_g": 0.4
}
而我真正希望的操作方式是:
今天早上吃了一根香蕉,帮我记录一下。
让 ChatGPT 自动识别食物、估算营养,再调用 MCP 工具保存。
不过,在连接 ChatGPT 之前,我们还需要进一步完善 Health Tracker 的基础功能。
下一章预告:实现运动、体重和断食记录
第四章,我们将在现有 SQLite 数据库中增加三张表,并开发对应的 MCP 工具:
record_exercise:记录运动类型、时长和消耗热量。record_weight:记录每天的体重。record_fasting:记录断食开始和结束时间。get_daily_summary:查询指定日期的综合健康记录。
完成后,我们就拥有了一套基本完整的健康数据管理工具,为后面接入 ChatGPT 做好准备。
想系统学习这门课程?
你已阅读完本文。需要更完整的知识体系,可以继续了解「Vibe Coding 实战课程」。
查看课程详情